০৮
পর্ব ৮ — ক্যাপস্টোন: এক কমান্ডে deploy, যাচাই আর log সংরক্ষণ
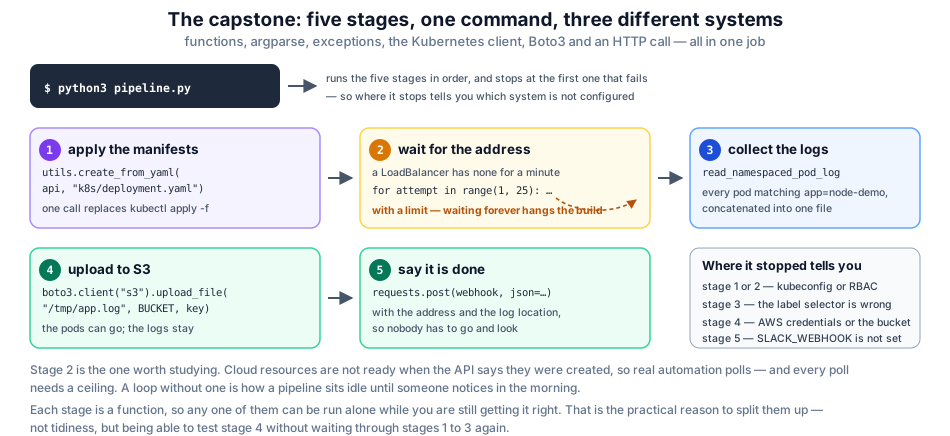
পুরো কোর্সটা একটা স্ক্রিপ্টে মেলে — manifest apply, LoadBalancer-এর ঠিকানার জন্য সীমিত অপেক্ষা, pod-এর log জোগাড়, S3-তে তোলা, আর Slack-এ খবর। সাথে অর্ধেক-সফল pipeline চেনা আর context বদলানোর বিপদ।
capstonekuberneteseksboto3s3pipelineslackautomation⏱ ~৫৫ মিনিট
💡 ধারণা
কী বানাচ্ছি, আর কেন এটাই শেষ পর্ব
এই পর্বে নতুন কোনো ধারণা নেই। যা আছে তা হলো আগের সাতটা পর্বের প্রতিটা জিনিস একসাথে, একটা কাজ করার জন্য।
কাজটা এক বাক্যে: এক কমান্ড দিলে অ্যাপ deploy হবে, তার ঠিকানা বেরোবে, log জমা হবে, আর দলকে জানানো হবে।
চারটে ধাপ, আর প্রতিটা আগের কোনো পর্ব থেকে আসছে:
কেন এটা গুরুত্বপূর্ণ? কারণ এটাই আসল পার্থক্য। আলাদা আলাদা পাঁচটা কাজ জানা এক জিনিস; সেগুলোকে ঠিক ক্রমে, ভুল সামলে, একটা কমান্ডে বাঁধা আরেক জিনিস। চাকরিতে দ্বিতীয়টার দাম।
আর একটা কথা যা মনে রাখার মতো: এই স্ক্রিপ্টটার আসল মূল্য সময় বাঁচানোয় নয়। হাতে করলে হয়তো দশ মিনিট লাগত। মূল্যটা হলো — প্রতিবার একই ভাবে হয়, কোনো ধাপ বাদ পড়ে না, আর কী হয়েছে তার একটা রেকর্ড থাকে।
হাতে করলে তৃতীয়বারে কেউ log তোলার ধাপটা ভুলে যাবে। স্ক্রিপ্ট ভোলে না।
💡 ধারণা
পাঁচটা স্ক্রিপ্ট না একটা — সিদ্ধান্তটা যেভাবে নিতে হয়
একটা স্বাভাবিক নকশা হলো প্রতিটা ধাপের জন্য একটা ফাইল: deploy.py, wait_lb.py, collect_logs.py, upload_s3.py, notify.py — আর একটা main.py যা পরপর সেগুলো চালায়।
শেখার সময় এটা চমৎকার, কারণ প্রতিটা ফাইল আলাদা করে পড়া আর চালানো যায়।
কিন্তু একটা সমস্যা আছে, আর সেটা বোঝা দরকার। যদি main.py এভাবে লেখা হয়:
os.system("python scripts/deploy_to_eks.py")
os.system("python scripts/update_lb.py")
os.system("python scripts/collect_logs.py")
তাহলে ধাপগুলোর মধ্যে কোনো কথা হয় না। update_lb.py যে ঠিকানাটা খুঁজে পেল, সেটা notify.py-তে পৌঁছাবে কীভাবে? আর deploy_to_eks.py ব্যর্থ হলে? os.system ফলাফল ফেরত দেয় বটে, কিন্তু কেউ সেটা দেখে না — তাই deploy ব্যর্থ হলেও পরের ধাপগুলো চলতেই থাকবে।
তিনটে বিকল্প, আর কখন কোনটা:
আমাদের pipeline.py তৃতীয় পথে গেছে, কারণ প্রতিটা ধাপ ছোট আর পরেরটা আগেরটার ফল ব্যবহার করে — ঠিকানা থেকে বার্তা, log থেকে S3-র পথ।
কিন্তু একটা জিনিস খেয়াল করার মতো: ফাইল এক হলেও ফাংশনগুলো আলাদা। wait_for_endpoint(), collect_logs(), upload() — প্রতিটা আলাদা করে ডাকা যায় আর পরীক্ষা করা যায়। এক ফাইল মানে এক গাদা কোড নয়।
আর যদি পরে কোনো ধাপ বড় হয়ে যায়, তখন সেটাকে নিজের ফাইলে সরানো সহজ — কারণ সে ইতিমধ্যেই একটা আলাদা ফাংশন।
▶ ডেমো
Manifest দুটো — আর LoadBalancer বনাম NodePort
k8s/deployment.yaml-এ দুটো object, --- দিয়ে আলাদা: একটা Deployment আর একটা Service।
Deployment-এ যা আছে তা পর্ব ৬-এর সেই একই গঠন। নতুনটা হলো Service, আর সেখানেই আসল সিদ্ধান্ত:
spec:
  type: LoadBalancer
  selector:
    app: node-demo
  ports:
    - protocol: TCP
      port: 80
      targetPort: 3000
port আর targetPort-এর পার্থক্যটা প্রথমেই স্পষ্ট করে নেওয়া দরকার, কারণ এটা নিয়েই সবচেয়ে বেশি বিভ্রান্তি হয়:
• port — Service-এর নিজের পোর্ট, বাইরের লোকে যেটায় আসে
বাকি অংশটা সাবস্ক্রাইবারদের জন্য
১৩০টি অংশের ২৬টি দেখানো হয়েছে, ১০৪টি বাকি