২২
ক্যাপস্টোন — তিন স্তরের একটা অ্যাপ্লিকেশন, হাতে একবার তারপর pipeline-এ
অটোমেশনের আগে যেটা থাকতে হয়, তিনটে স্তর আর তাদের মাঝের দুটো সীমানা, চালানোর মাপ বনাম build করার মাপ, reverse proxy-র ভেতরে একটা অনুরোধের পুরো পথ, provision আর deploy-র ভাগাভাগি, গোপন কথা রাখার সৎ উপায়, systemd বনাম `&`, আর শেষে একই script একটা pipeline-এ — host key, OIDC পরিচয় আর প্রমাণের তালিকা সহ।
capstonethree-tiernginxsystemddeploy scriptci/cdsecrets⏱ ~৫০ মিনিট
💡 ধারণা
অটোমেশনের আগে যেটা থাকতে হয়
একুশটা পর্ব হয়ে গেছে। এই শেষ পর্বে একটা সত্যিকারের অ্যাপ্লিকেশন সার্ভারে উঠবে — প্রথমে হাতে, তারপর একটা pipeline-এ। আর ক্রমটা এই পর্বের সবচেয়ে গুরুত্বপূর্ণ সিদ্ধান্ত, তাই ওটা দিয়েই শুরু।
প্রশ্ন: হাতে করার দরকারটা কী? সোজা pipeline লিখে ফেললেই তো হয়।
উত্তরটা একটা বাক্যে:
যে কাজটা তুমি কখনো নিজে করোনি, সেটা তুমি অটোমেট করতে পারো না।
কারণ অটোমেশন মানে কাজটা বোঝা নয় — অটোমেশন মানে কাজটার ধাপগুলো লিখে রাখা। আর যে ধাপগুলো তুমি জানো না, সেগুলো লেখাও যায় না।
আর এই ভুলটার ফলাফল খুব নির্দিষ্ট: একটা pipeline যেটা সবুজ দেখায় কিন্তু সার্ভারে পুরনো কোডই চলছে। অথবা একটা pipeline যেটা ব্যর্থ হয় আর তুমি জানো না কোন ধাপে ব্যর্থ হলো, কারণ কোনো ধাপই তুমি কখনো নিজে চালাও নি।
তখন তোমার একটা সমস্যার বদলে দুটো: অ্যাপ্লিকেশনটা চলছে না, আর যে যন্ত্রটা ওটা চালানোর কথা, সেটাও তুমি বোঝো না।
এখন একটা সৎ পরীক্ষা, নিজের কাছে। একটা অ্যাপ্লিকেশন সার্ভারে চলছে — তুমি কি প্রতিটা প্রসেসের নাম বলতে পারো যেগুলো চালু থাকা দরকার একটা অনুরোধ সফল হওয়ার জন্য?
প্রশ্নটা তুচ্ছ শোনায়, কিন্তু উত্তর দিতে গেলে দেখা যায় অনেকের উত্তর হলো "অ্যাপটা চলছে"। আর "অ্যাপটা" একটা প্রসেস নয় — এখানে তিনটে প্রসেস আছে, তিনটে আলাদা পোর্টে, আর তিনটে আলাদাভাবে মরতে পারে।
শেষ সারিটা এই পর্বের অর্ধেক। "অ্যাপটা চলছে" আর "অ্যাপটা reboot-এর পরেও চলবে" দুটো সম্পূর্ণ আলাদা অবস্থা, আর তাদের মধ্যে একটা ফাইলের পার্থক্য।
তাই এই পর্বের গঠনটা এরকম:
আর লক্ষ্য করো ৩ নম্বরে নতুন কিছু নেই — pipeline ঠিক ওই script-টাই চালায়। Pipeline যোগ করে শুধু দুটো জিনিস: একটা trigger আর একটা পরিচয়। বাকিটা তোমার লেখা।
আর এটাই DevOps-এর পুরো ধারণাটার সারমর্ম, যেটা এই কোর্সের প্রথম পর্বে বলা হয়েছিল অন্য ভাষায়:
অটোমেশন বুদ্ধিমান কিছু নয় — অটোমেশন হলো একটা জানা কাজ লিখে রাখা। আর তাই যে কাজটা জানা নয়, সেটার অটোমেশন নেই, কেবল একটা না-বোঝা যন্ত্র।
💡 ধারণা
তিনটে স্তর, আর তাদের মাঝের দুটো সীমানা
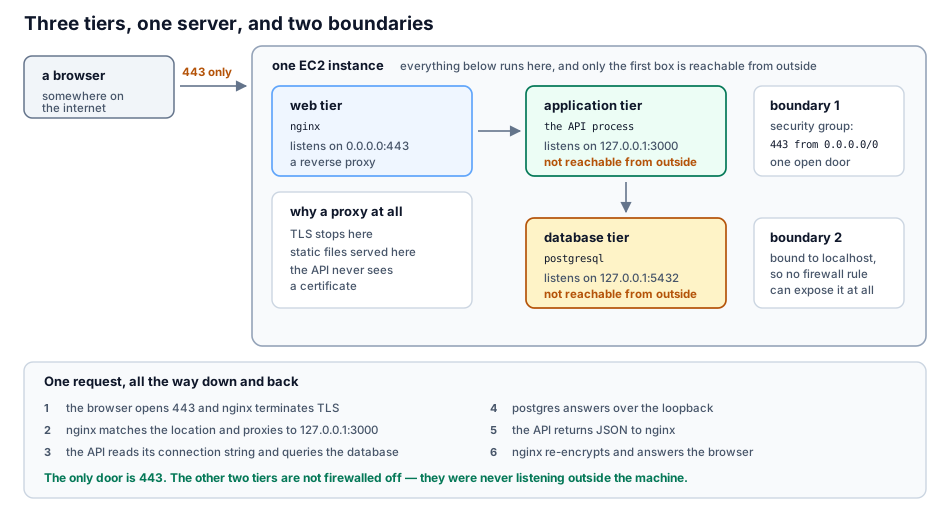
যে অ্যাপ্লিকেশনটা উঠবে সেটা সাধারণ, আর সেটাই ভালো — কারণ গঠনটা শেখার জিনিস, অ্যাপটা নয়:
তিনটে স্তর একই মেশিনে, আর সেটা শেখার জন্য ঠিক আছে। আসল জিনিসটা স্তরগুলোর সংখ্যা নয় — আসল জিনিসটা তাদের মাঝের সীমানা।
আর এখন এই পর্বের সবচেয়ে ভুল-বোঝা অংশটা। সীমানা দুটো, আর দুটো সম্পূর্ণ আলাদা ধরনের:
সীমানা ১ — security group (পর্ব ৬)
443 from 0.0.0.0/0     <- একটাই খোলা দরজা
22  from <your ip>/32  <- তোমার ঘর থেকে, পৃথিবী থেকে নয়
সীমানা ২ — কোন ঠিকানায় প্রসেসটা bind করেছে
আর এটাই ভুল বোঝা হয়। API আর ডেটাবেস বাইরে থেকে পৌঁছানো যায় না — কিন্তু সেটা firewall-এর কারণে নয়।
সেটা এই কারণে যে ওরা 127.0.0.1-এ bind করেছে, তাই ওরা মেশিনের বাইরে কখনোই শুনছিল না।
আর এই পার্থক্যটা কেন গুরুত্বপূর্ণ:
তাই নিয়মটা হলো: যে জিনিসটার বাইরে থেকে পৌঁছানোর দরকার নেই, সেটাকে firewall দিয়ে আটকিও না — সেটাকে বাইরে শুনতেই দিও না।
প্রথমটা একটা configuration, যেটা ভুল হতে পারে। দ্বিতীয়টা একটা অবস্থা, যেটা ভুল হওয়ার সুযোগ কম।
আর ডেটাবেসের ক্ষেত্রে এটা সবচেয়ে জরুরি, কারণ ইন্টারনেটে খোলা ডেটাবেস খুঁজে বেড়ানো একটা স্বয়ংক্রিয় পেশা — পর্ব ৬-এর সেই ৫৪৩২ পোর্টের কথাটা মনে করো।
এখন তৃতীয় একটা জিনিস, যেটা এই নকশার ফল: nginx থাকার কারণে API-টা কখনো একটা certificate দেখে না।
TLS শেষ হয় nginx-এ। API-টা সাধারণ HTTP-তে localhost-এ কথা বলে। আর এর ফল তিনটে:
• Certificate একটা জায়গায় — একটা প্রসেস ওটা জানে, বাকিরা না
• API-র কোডে TLS-এর কোনো চিহ্ন নেই — লোকাল মেশিনে আর সার্ভারে অ্যাপটা একই
• API-র পোর্ট বদলানো একটা ভেতরের ব্যাপার — বাইরের কেউ টের পায় না
আর শেষ পয়েন্টটা পর্ব ২১-এর সেই decoupling-এর ছোট সংস্করণ: একটা জিনিসের সামনে আরেকটা জিনিস বসালে পেছনের জিনিসটা বদলানোর স্বাধীনতা তৈরি হয়।
⚠️ সতর্কতা
সার্ভারের মাপ — চালানোর মাপ আর build করার মাপ এক নয়
সার্ভারটা কত বড় হওয়া উচিত? প্রশ্নটা সহজ শোনায়, আর উত্তরটা দুটো সংখ্যা, একটা নয়।
aws ec2 describe-instance-types --instance-types t3.micro
TYPE       VCPU  MEMORY  FAMILY     TYPICAL USE
t3.micro   2     1 GiB   burstable  free tier
t3.small   2     2 GiB   burstable  small services
t3.medium  2     4 GiB   burstable  builds
t3.micro-তে ১ GiB মেমরি। আর একটা ছোট API চালানোর জন্য সেটা যথেষ্ট — nginx ৪ মেগাবাইট, API প্রসেসটা হয়তো ৮০, postgres একটা ছোট ডেটাবেসে ১৫০।
কিন্তু তারপর তুমি npm run build চালাবে, আর এই লেখাটা দেখবে:
$ npm run build
> next build

  ▲ Next.js 16.2.9
  Creating an optimized production build ...
Killed
$ echo $?
137
আর "Killed" শব্দটা একটা error message নয় — ওটা একটা মৃত্যুসংবাদ।
কোনো stack trace নেই, কোনো কারণ নেই, কেবল একটা শব্দ। কারণ প্রসেসটা নিজে ব্যর্থ হয়নি — কার্নেল ওটাকে মেরে ফেলেছে, মেমরি শেষ হয়ে যাওয়ায়। আর যে মারে, সে ব্যাখ্যা লিখে রাখে না।
Exit code 137-টাই আসল সূত্র: 128 + 9, আর ৯ হলো SIGKILL। তাই ১৩৭ মানে সর্বদা "কেউ এটাকে মেরেছে", আর সার্ভারে সেই কেউ প্রায় সবসময় OOM killer।
আর নিশ্চিত হতে চাইলে প্রমাণটা log-এ আছে:
বাকি অংশটা সাবস্ক্রাইবারদের জন্য
২৫২টি অংশের ৫১টি দেখানো হয়েছে, ২০১টি বাকি